Perceptron: A Unidade Fundamental que Deu Origem às Redes Neurais
Uma análise do artigo seminal de Frank Rosenblatt (1957) que apresentou o Perceptron — o primeiro modelo matemático de um neurônio artificial e a semente de toda a revolução do aprendizado profundo.
Antes dos Transformers, antes do backpropagation, antes mesmo do conceito de “deep learning”, houve o Perceptron. Em 1957, o psicólogo e pesquisador Frank Rosenblatt, trabalhando no Cornell Aeronautical Laboratory, publicou um artigo intitulado “The Perceptron: A Perceiving and Recognizing Automaton” que propunha um modelo matemático simplificado de como um neurônio biológico poderia “aprender”.
O Perceptron é, até hoje, a unidade computacional mais fundamental de toda a inteligência artificial moderna. Entender como ele funciona — e onde ele falha — é entender a base sobre a qual redes neurais, deep learning e, por extensão, os Transformers de hoje foram construídos.
O Contexto: Como o Cérebro Inspirou a Máquina
Em meados da década de 1950, a comunidade científica começava a levar a sério a ideia de que máquinas poderiam simular processos inteligentes. Dois nomes pavimentaram o caminho:
-
Warren McCulloch e Walter Pitts (1943) — propuseram um modelo matemático binário de um neurônio, baseado em lógica proposicional. O neurônio de McCulloch-Pitts recebia entradas binárias, aplicava pesos e produzia uma saída binária. Era um modelo teórico poderoso, mas não aprendia — os pesos precisavam ser definidos manualmente.
-
Donald Hebb (1949) — propôs a regra de aprendizado que leva seu nome: “Neurons that fire together, wire together.” Se dois neurônios disparam simultaneamente, a conexão entre eles deve ser fortalecida. Era uma teoria biológica, não um algoritmo computacional.
Rosenblatt combinou ambas as ideias: a arquitetura de McCulloch-Pitts com um mecanismo de aprendizado inspirado em Hebb. O resultado foi o Perceptron.
A Arquitetura do Perceptron
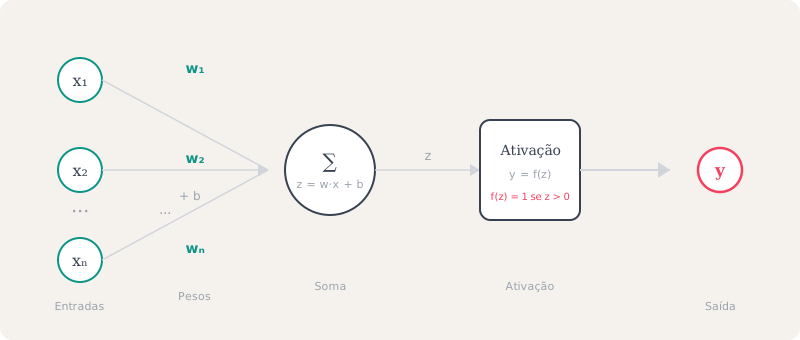
O Perceptron é enganosamente simples. Ele recebe um vetor de entradas, multiplica cada uma por um peso, soma tudo e aplica uma função de ativação. A saída é uma decisão binária: sim ou não, classe A ou classe B.
Matematicamente
Dado um vetor de entradas x = (x₁, x₂, …, xₙ) e um vetor de pesos w = (w₁, w₂, …, wₙ), o Perceptron calcula:
z = w₁·x₁ + w₂·x₂ + ... + wₙ·xₙ + bOnde b é o viés (bias) — um termo que permite ao modelo fazer classificações mesmo quando todas as entradas são zero.
Em notação vetorial:
z = w · x + bA saída final é uma função degrau (step function):
y = 1  se z > 0
y = 0  se z ≤ 0
Visualmente
      x₁ → w₁
      x₂ → w₂        soma
      x₃ → w₃  →  (∑)  →  f(z)  →  y
      x₄ → w₄        + b
Cada peso wᵢ representa a “força” da conexão entre aquela entrada e o neurônio. Pesos positivos excitam o neurônio; pesos negativos o inibem.
O Algoritmo de Aprendizado
O Perceptron aprende ajustando seus pesos com base nos erros que comete. O algoritmo é surpreendentemente simples:
- Inicialize os pesos com valores aleatórios pequenos.
- Para cada exemplo de treinamento (x, y_real):
- Calcule a saída y_pred
- Se y_pred == y_real, não faça nada (acertou)
- Se y_pred ≠ y_real, atualize os pesos:
- wᵢ ← wᵢ + η · (y_real - y_pred) · xᵢ
- b ← b + η · (y_real - y_pred)
Onde η (eta) é a taxa de aprendizado — um hiperparâmetro que controla o tamanho dos ajustes.
Essa regra de atualização é uma implementação direta do princípio de Hebb: se o neurônio deveria ter disparado mas não disparou (y_real=1, y_pred=0), os pesos das entradas ativas são aumentados. Se disparou quando não deveria (y_real=0, y_pred=1), os pesos das entradas ativas são diminuídos.
Convergência Garantida — O Teorema do Perceptron
Rosenblatt provou que, se os dados forem linearmente separáveis, o algoritmo do Perceptron converge para uma solução em um número finito de passos. Este resultado, conhecido como Teorema da Convergência do Perceptron, foi provado rigorosamente por Block (1962) e Novikoff (1963).
Mas essa garantia vem com uma condição crucial: os dados precisam ser linearmente separáveis.
O Problema: Limitação Linear
Um classificador é linear se ele consegue separar as classes com uma linha reta (em 2D), um plano (em 3D) ou um hiperplano (em dimensões maiores).
O que o Perceptron consegue fazer
- Classificar e-mails como spam ou não-spam baseado no número de palavras suspeitas
- Decidir se aprovar ou negar um empréstimo baseado na renda e no histórico de crédito
- Detectar se um dígito manuscrito é maior que 5 ou menor que 5
Todos esses problemas são linearmente separáveis — existe uma fronteira em linha reta que divide as classes.
O que o Perceptron NÃO consegue fazer
Em 1969, Marvin Minsky e Seymour Papert publicaram o livro “Perceptrons”, que demonstrou matematicamente as limitações fundamentais do Perceptron. O exemplo mais famoso é a função XOR:
| x₁ | x₂ | XOR |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
Não existe uma única linha reta que separe os pontos (0,0) e (1,1) dos pontos (0,1) e (1,0). O Perceptron simplesmente não consegue aprender XOR — uma função lógica que até uma criança entende.
Minsky e Papert mostraram que isso não era uma limitação técnica contornável com mais dados ou mais parâmetros. Era uma limitação fundamental de modelos de apenas uma camada.
A Consequência: O Primeiro Inverno da IA
A publicação de “Perceptrons” teve um efeito devastador na pesquisa de redes neurais. Financiamentos foram cortados, pesquisadores migraram para outras áreas e o campo entrou no que ficou conhecido como o primeiro inverno da IA (1969-1980).
A ironia, como o próprio Minsky reconheceu mais tarde, é que eles já sabiam que redes de múltiplas camadas (Perceptrons de várias camadas) poderiam resolver XOR. O problema era que não havia um algoritmo de treinamento eficiente para essas redes multicamadas — o backpropagation só seria popularizado por Rumelhart, Hinton e Williams em 1986.
O Legado: Por que o Perceptron Importa Hoje
1. A Unidade Fundamental de Tudo
Cada neurônio em uma rede neural moderna — seja ela uma MLP, uma CNN, uma RNN ou um Transformer — é essencialmente um Perceptron com uma função de ativação diferente. Em vez da função degrau, usamos hoje:
- Sigmoid — saída entre 0 e 1, útil para probabilidades
- Tanh — saída entre -1 e 1, centraliza os dados
- ReLU — max(0, z), a mais usada em deep learning
- GELU, Swish — variações suaves da ReLU
A mudança da função degrau para funções de ativação contínuas e diferenciáveis foi o que tornou o backpropagation possível. O Perceptron original usava uma função degrau — que não é diferenciável — e por isso não podia ser treinado com gradiente descendente.
2. A Origem do Neurônio Artificial
O Perceptron é o “átomo” da IA. Uma camada densa em qualquer rede neural moderna (Keras Dense, PyTorch Linear) é simplesmente uma coleção de Perceptrons processados em paralelo:
import torch

# Um Perceptron em PyTorch
layer = torch.nn.Linear(in_features=10, out_features=1)
# Isto é: y = X · w^T + b
Uma MLP (Multi-Layer Perceptron) de duas camadas com ReLU resolve XOR. Uma de N camadas com centenas de neurônios pode aproximar qualquer função — este é o Teorema da Aproximação Universal (Cybenko, 1989; Hornik, 1991).
3. A Lição para o Futuro
A história do Perceptron nos ensina algo importante sobre IA: limitações fundamentais não são o fim, mas o começo de uma próxima iteração. O Perceptron simples não podia aprender XOR — mas isso não matou as redes neurais. Pelo contrário, forçou a próxima inovação (backpropagation, MLPs), que por sua vez levou a CNNs, RNNs e, eventualmente, Transformers.
Conclusão
O Perceptron é o ponto de partida de toda a inteligência artificial moderna. Simples o suficiente para ser compreendido em uma tarde, ele contém os princípios essenciais que governam até os modelos mais avançados de hoje: entradas ponderadas, soma, ativação não-linear e aprendizado baseado em erro.
Rosenblatt não viveu para ver o impacto de sua criação — ele morreu em um acidente de barco em 1971, aos 43 anos. Sete anos depois, o backpropagation começaria a reviver suas ideias. Quatro décadas depois, os Perceptrons que ele imaginou, agora empilhados em centenas de camadas com bilhões de conexões, estariam conversando conosco, escrevendo código e gerando imagens.
Referências
- Rosenblatt, F. (1957). The Perceptron: A Perceiving and Recognizing Automaton. Cornell Aeronautical Laboratory.
- Rosenblatt, F. (1958). The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain. Psychological Review, 65(6), 386-408.
- Minsky, M., & Papert, S. (1969). Perceptrons: An Introduction to Computational Geometry. MIT Press.
- Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning Representations by Back-Propagating Errors. Nature, 323, 533-536.
- Cybenko, G. (1989). Approximation by Superpositions of a Sigmoidal Function. Mathematics of Control, Signals, and Systems, 2(4), 303-314.
- Block, H. D. (1962). The Perceptron: A Model for Brain Functioning. Reviews of Modern Physics, 34(1), 123-135.